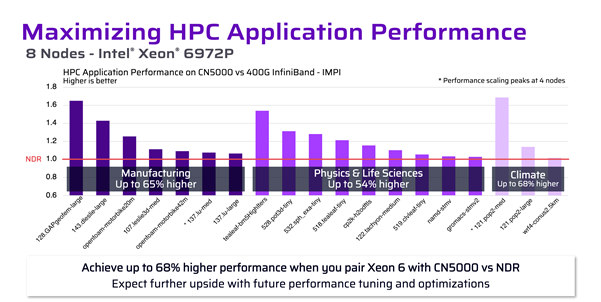
Les communautés de la physique et des sciences de la vie en Europe s'engagent dans une nouvelle ère de calcul à très grande échelle : des systèmes de classe exascale, des IA à des milliards de paramètres, des instruments gourmands en données et des flux de travail qui mélangent simulation, analyse et IA dans un même travail. Voici la dure vérité que la plupart des gens n'admettent qu'après un premier test d'échelle brutal : le réseau est le goulot d'étranglement, pas les GPU, pas le stockage, pas même le CPU.
C’est là que la conception et la livraison de la solution HPC de Cornelis CN5000 Omni-Path® et de Hammer s’assemblent : une structure conçue pour rester prévisible sous forte charge, associée à une approche qui aide les organisations européennes à concevoir, valider, déployer et soutenir l’architecture qui correspond à leurs applications.
Ce qui a changé dans l'informatique de recherche européenne et pourquoi le réseau est plus important que jamais
La physique et les sciences de la vie rencontrent toutes deux des points de pression similaires :
- Collectifs MPI à grande échelle (allreduce/alltoall), sensibles à la latence de queue
- De nombreux petits messages où le débit de messages compte autant que la bande passante
- Trafic incast et en rafales (courant dans l'entraînement IA, la reconstruction et les mélanges analytiques)
- Simulation à forte synchronisation où la gigue se transforme en temps de calcul gaspillé
Lorsqu'un interconnect est congestionné ou introduit des délais à longue traîne, vous voyez l'utilisation s'effondrer - des accélérateurs coûteux restent inactifs, attendant le prochain lot ou la prochaine collectivité pour se terminer.
CN5000 en termes simples : ce que c'est et ce qu'il est conçu pour corriger
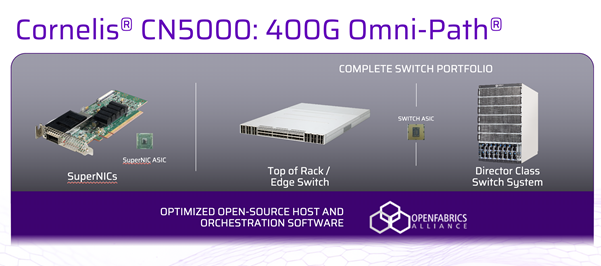
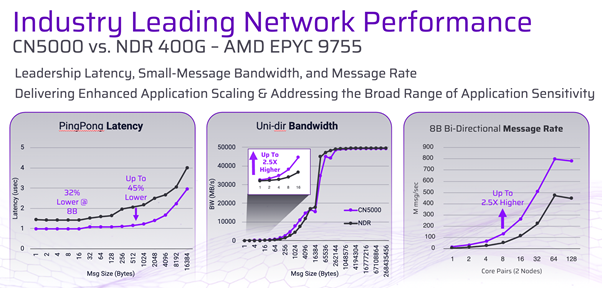
Cornelis CN5000 Omni-Path est une plateforme réseau évolutive destinée aux environnements IA et HPC où un débit élevé et des performances stables sont requis, même lorsque le système est occupé.
Quelques points pratiques qui comptent pour les équipes HPC :
- Commutation 400G par port (les commutateurs CN5000 sont généralement référencés comme étant de classe 400G à 48 ports, offrant une bande passante agrégée très élevée par commutateur)
- Capacité de traitement de paquets très élevée (critique pour le trafic HPC à petits messages)
- Une conception axée sur l'évitement des chutes de performance grâce à un comportement sans perte, une gestion de la congestion du réseau, un routage multi-chemins et un contrôle de flux robuste
L'idée centrale : garder la communication prévisible lorsque le cluster est plein de tâches réelles, et non seulement lors de l'exécution de tests idéalisés sur un réseau calme.
Où Hammer s'intègre pour transformer la capacité du CN5000 en une solution européenne déployable
CN5000 est la technologie de réseau. La valeur de Hammer réside dans sa capacité à la faire fonctionner dans le monde réel - en équilibrant les objectifs de performance avec les contraintes d'approvisionnement, les délais, les normes du site et la préparation opérationnelle.
En pratique, cela signifie généralement :
- Traduire les besoins des applications (MPI, entraînement IA, analyses de pipelines) en une conception de tissu évolutif
- -Valider les performances avec les bons tests (pas seulement les benchmarks par défaut du fournisseur
- Fournir une solution intégrée :
- Commutation
- Câblage
- Connectivité hôte
- Configuration
- Support de déploiement progressif
- Aider les équipes à opérationnaliser :
- Surveillance
- Contrôle des changements
- Stratégie de pièces de rechange
- Modèles de support de deuxième jour
Tableau comparatif : CN5000 vs approches courantes d'interconnexion HPC/IA
La “meilleure” interconnexion dépend de la charge de travail, de l'échelle et des préférences opérationnelles. Le tableau ci-dessous est une comparaison pratique au niveau de l'architecture que vous pouvez utiliser lors des discussions de conception en phase initiale.
|
Critère |
Cornelis CN5000 Omni-Path |
InfiniBand (générations modernes) |
Ethernet (RoCE / Ethernet haute performance) |
|
Objectif de conception principal |
Extension AI + HPC avec des temps d'achèvement prévisibles sous charge |
Extension HPC/AI, largement adoptée dans le HPC haut de gamme |
Centre de données large + AI/HPC où l'alignement des normes et les outils communs sont essentiels |
|
Behaviour under congestion |
Conçu pour minimiser l'impact de la congestion et maintenir des performances stables (intention de réseau sans perte) |
Options robustes selon la configuration et le contrôle de congestion |
Peut être excellent, mais tend à être plus sensible à un réglage correct (PFC/ECN, buffering, QoS) |
|
Sensibilité à la latence de queue |
Généralement optimisé pour une faible latence et un débit de messages élevé |
Généralement, très performant pour la faible latence et les collectifs |
Peut être compétitif, mais la latence de queue peut se dégrader en cas de mauvaise configuration ou de sursouscription |
|
Complexité opérationnelle |
Outils et modèles axés sur le HPC ; généralement, plus “fabric-first” |
Écosystème mature ; modèles opérationnels solides en HPC |
Familier aux équipes réseau, mais “RoCE de qualité HPC” exige généralement une discipline de conception rigoureuse |
|
Écosystème et intégration |
Conçu pour les piles HPC/IA ; l’intégration dépend des choix de plateforme |
Très large support de l’écosystème HPC |
Écosystème de fournisseurs/outils le plus large dans l'ensemble |
|
Point idéal typique |
Collectifs serrés, HPC à fort débit de messages, clusters mixtes IA/HPC où la prédictibilité est la priorité |
Déploiements HPC/IA très importants avec des pratiques IB établies |
Sites standardisant sur Ethernet, charges de travail mixtes, ou recherchant un modèle opérationnel de réseau unifié |
|
Risque courant en cas de mauvais choix |
Validation sous-dimensionnée (ne pas tester les modèles de charge réels tôt) |
Planification des coûts/disponibilité ; les choix de conception comptent à grande échelle |
“C'est de l'Ethernet, ça ira” penser, jusqu'à ce que des tempêtes PFC, des lacunes QoS ou des voisins bruyants apparaissent |
Si vous voulez une règle simple : le HPC et l'IA scientifique n'ont pas seulement besoin de liaisons rapides ; ils ont besoin d'un réseau qui reste stable lorsque tout le monde communique en même temps.
Un plan pratique : déploiement du CN5000 pour la physique et les sciences de la vie en Europe
1) Commencez par le profil de communication (pas le nombre de ports)
Posez des questions comme :
- Sommes-nous dominés par les collectifs (allreduce/alltoall) ?
- Sommes-nous limités par le débit de messages (beaucoup de petits messages) ?
- Observons-nous des chutes de performance lorsque le système est occupé ?
- Les GPU attendent-ils la synchronisation ?
Cela détermine si vous devez optimiser pour la bande passante, la latence, le comportement de queue, ou une approche équilibrée.
2) Concevoir pour des étapes de mise à l'échelle, pas pour un instantané unique
De nombreuses organisations européennes évoluent par phases :
- Preuve de valeur à l'échelle d'un pod ou d'un rack
- Production multi-racks
- Croissance multi-cluster ou fédérée
Une conception de fabric CN5000 doit refléter cela dès le premier jour, y compris la topologie, la stratégie de câblage, les ports de croissance et les limites opérationnelles.
3) Valider avec la science réelle Ne vous arrêtez pas aux microbenchmarks. Incluez :
- Collectifs MPI à l'échelle prévue
- Mini-applications et noyaux représentatifs
- Tests de communications d'entraînement IA (étapes à forte intensité collective)
- Tests de stress multi-locataires si vous exécutez une infrastructure partagée
L'objectif est de repérer tôt les « victoires en laboratoire calme » par rapport aux « victoires en conditions réelles de production », alors que les changements sont encore peu coûteux.4) Opérationnaliser tôt (car le jour 2 est là où les projets réussissent ou échouent)
Planifier pour :
- Télémétrie et tableaux de bord (latence, signaux de congestion, erreurs de lien, points chauds)
- Gestion des changements (micrologiciel, dérive de configuration, déploiement contrôlé)
- Planification des pièces de rechange et de la résilience
C'est ici que l'approche de livraison et de support de Hammer’s peut combler l'écart entre une infrastructure rapide et un service gérable.
Modèles d'architecture de référence pour les laboratoires et instituts de recherche européens
Voici trois modèles courants qui fonctionnent bien lors de la construction autour de CN5000 pour les environnements de physique et de sciences de la vie
Modèle A : “Pod scientifique” pour une adoption rapide
- 1–2 racks de calcul (CPU ou GPU)
- Commutateurs de feuille CN5000 dédiés
- Limites claires d'entrée/sortie vers le stockage et le réseau du campus plus large
- Idéal pour prouver les gains de charge de travail réels et former les équipes d'exploitation
Modèle B : Cluster de production mixte IA + HPC
- Partitions ou files d'attente logiques distinctes pour :
- Entraînement IA
- Simulation
- Pipelines de données
- Fabric conçu pour éviter les impacts des voisins bruyants lors des pics d'entraînement
- Accent sur des collectifs prévisibles et des temps d'achèvement de tâches stables
Modèle C : Croissance multi-clusters avec services partagés
- Plusieurs clusters basés sur CN5000 (par exemple, imagerie en sciences de la vie, simulation physique)
- Services partagés :
- Authentification
- Politique d'ordonnancement
- Surveillance
- Stockage
- La stratégie de fabric met l'accent sur la reproductibilité : “Nous pouvons redéployer cela en toute confiance.”
Il n'existe pas de conception unique “correcte” -- c'est que vous pouvez aligner la topologie et le modèle opérationnel sur la façon dont votre organisation fonctionne réellement.
Gouvernance des données, sécurité et collaboration à travers l'Europe
Les sciences physiques et les sciences de la vie se situent souvent aux extrémités opposées du spectre de la gouvernance des données – allant de données expérimentales relativement ouvertes dans certains domaines de la physique, à des données humaines hautement sensibles dans certaines parties des sciences de la vie. La conception moderne des réseaux HPC doit reconnaître cette réalité.
Lors du déploiement d'une infrastructure basée sur CN5000 dans des environnements européens, il est essentiel d'intégrer
- Segmentation par conception (projets, locataires, ensembles de données réglementés)
- Contrôle des changements auditable (qui a changé quoi, quand et pourquoi)
- Limites claires vers le stockage et les réseaux externes (minimiser les chemins de données surprises)
- Préparation à la collaboration (prise en charge des modèles d'accès fédérés, le cas échéant
Rien de tout cela n’est spectaculaire, mais c’est souvent la différence entre “un cluster rapide” et “une plateforme en laquelle l’organisation peut avoir confiance pour les cinq prochaines années”.
Cas d'utilisation courants où la livraison CN5000 + Hammer peut faire la différence
Entraînement de l'IA pour les modèles scientifiques
- Les collectifs, les points de synchronisation et les schémas de rafales dominent
- La prévisibilité sous charge est ce qui améliore le temps d'obtention des résultats
Simulation à grande échelle avec points de synchronisation
- La latence de queue et la gigue peuvent gravement affecter la simulation physique étroitement couplée
- La capacité de débit de messages et un comportement stable sont importants
Pipeline d'imagerie, de reconstruction et de multi-omique
- Les flux de travail mélangent des étapes gourmandes en bande passante et des mélanges intensifs en communication
- Souvent exécutées simultanément par plusieurs équipes
FAQ : Comment le CN5000 Omni-Path aide dans les clusters HPC + IA réels
Comment le Cornelis CN5000 Omni-Path améliore-t-il les performances HPC et IA dans les clusters réels ?
Dans les clusters de production, le débit n’est souvent pas le facteur limitant, ce sont la congestion et la latence de longue traîne. CN5000 est conçu pour maintenir des communications prévisibles sous charge, afin que les travaux ne rencontrent pas de “gouffres de performance” lorsque de nombreux locataires ou de nombreux rangs communiquent simultanément.
Concrètement, cela provient d'une conception Omni-Path qui met l'accent sur :
- Comportement sans perte avec contrôle de flux basé sur le crédit (afin d’éviter les spirales de perte/retransmission sous pression).
- Routage adaptatif fin / multi-chemin pour contourner les points chauds transitoires.
- Gestion active de la congestion (souvent décrite comme un rythme/ralentissement informé par le commutateur) pour réduire les effets de queue.
L'effet net : moins de blocages dans les collectifs et les phases de synchronisation, et une meilleure utilisation des accélérateurs lorsque le réseau est occupé.
Quels types de charges de travail bénéficient le plus du CN5000 en physique et en sciences de la vie ?
Le CN5000 tend à donner le meilleur de lui-même lorsque la gigue et la latence de queue dominent les résultats, en particulier :
- Collectives MPI serrées (par ex., allreduce/alltoall) à grande échelle
- Applications à haut débit de messages avec de nombreux petits messages
- Simulations à forte synchronisation où quelques rangs lents entraînent le pas de temps
- Trafic en rafales ou à forte incast observé dans l'entraînement IA multi-nœuds, les pipelines de reconstruction et les analyses à forte lecture aléatoire
Si votre profilage montre un temps croissant passé dans les collectives, les barrières ou les échanges de halo lors de la montée en charge, c'est le type de problème que le CN5000 est conçu pour résoudre.
Pourquoi le réseau devient-il le goulot d'étranglement avant les GPU ou le stockage à grande échelle ?
À mesure que les clusters évoluent, plus de temps réel est consacré à la coordination (gradients, réductions, échanges, barrières. Lorsque des congestions ou des retards de longue traîne apparaissent, les nœuds et GPU les plus rapides finissent par attendre les événements de communication les plus lents. L'utilisation peut s'effondrer même si la “bande passante de pointe” semble solide sur le papier.
Que signifie “sans perte” en pratique En pratique, “sans perte” consiste à éviter la perte de paquets et la retransmission qui amplifient la congestion et créent des pics de latence. Ces pics se manifestent par des collectifs lents et des temps d'achèvement de travaux imprévisibles.
CN5000 est positionné autour d'une transmission sans perte et sans congestion utilisant un contrôle de flux basé sur le crédit et un routage adaptatif pour maintenir la stabilité sous charge mixte.
En quoi le CN5000 diffère-t-il d'InfiniBand ou d'Ethernet haute performance (RoCE) ?
À un niveau élevé :
- CN5000 (Omni-Path) : Positionné comme une matrice d'extension de bout en bout optimisée pour des performances prévisibles sous charge, exploitant un comportement sans perte, un routage adaptatif et un contrôle de congestion comme objectifs de conception de première classe.
- InfiniBand : largement déployé dans le HPC haut de gamme avec un écosystème profond et des pratiques opérationnelles matures (excellentes performances, large support des fournisseurs).
- RoCE / Ethernet haute performance : Familiers sur le plan opérationnel et capables de performances élevées, mais nécessitent généralement une discipline autour de la conception PFC/ECN, de la mise en mémoire tampon, de la QoS et du contrôle des voisins bruyants pour éviter les surprises de latence de queue à grande échelle.
Il convient également de le dire clairement : les « avantages complets » du CN5000 sont généralement décrits comme provenant d'une solution Omni-Path de bout en bout (commutateurs + cartes réseau) plutôt que d'un mélange dans le chemin de données.
Que livre réellement Hammer dans un projet HPC basé sur CN5000 ?
Hammer transforme l'interconnexion en quelque chose que vous pouvez exploiter au quotidien, couvrant généralement :
- Exigences → conception du réseau : (topologie, objectifs de sursouscription, plan de croissance, stratégie de câblage)
- Validation : des plans de test qui reflètent les charges de travail réelles (pas seulement des microbenchmarks en laboratoire calme)
- Construction et déploiement : commutateurs, optiques/câbles, connectivité hôte, modèles de configuration, support de bascule
- Opérations : attentes en matière de surveillance/télémétrie, contrôle des changements, stratégie de pièces de rechange et runbooks de support
Comment devrions-nous valider une structure CN5000 avant de nous engager dans un déploiement complet ?
Une validation pratique avant le déploiement comprend généralement :
- Tests collectifs MPI à l'échelle prévue (pas seulement sur un seul rack)
- Mini-applications / noyaux représentatifs de votre base d’utilisateurs réelle
- Tests de communication IA qui sollicitent les étapes intensives en collectifs (et les schémas de chevauchement)
- Tests de stress multi-locataires pour révéler les effets de voisin bruyant et le comportement de longue traîne
L'objectif : détecter les cas où les « victoires en laboratoire calme » ne se traduisent pas en production—pendant que les changements de topologie et de politique sont encore peu coûteux.
Comment concevoir un réseau CN5000 pour une croissance progressive sur les sites de recherche européens ?
De nombreux programmes évoluent par phases (pod → multi-baie → multi-cluster/fédération). Les choix de conception courants qui rendent la croissance sans douleur :
- Choisissez une topologie avec un chemin d'expansion clair (ports réservés pour la croissance, câblage prévisible)
- Définissez tôt les limites opérationnelles (tenants/partitions/files d'attente, attentes en matière de QoS)
- Planifiez la gestion du contrôle des changements et du « rayon d'impact » lors de l'ajout de racks ou de sites
De cette façon, la mise à l’échelle n’introduit pas accidentellement de nouveaux points chauds ou un comportement de voisin bruyant
Comment les déploiements CN5000 peuvent-ils soutenir la gouvernance des données et la sécurité en Europe ?
Dans les environnements de sciences de la vie réglementés, le réseau fait partie du plan de contrôle pour la gouvernance. Les schémas typiques incluent :
- Segmentation par projet/locataire (afin que les ensembles de données réglementés ne partagent pas des chemins surprises)
- Configuration auditable + contrôle des changements aligné sur votre modèle de sécurité
- Des limites claires vers le stockage et les réseaux externes pour éviter les routes de sortie de données accidentelles
- Lorsqu'une collaboration est nécessaire, privilégiez des modèles d'accès fédérés délibérés plutôt qu'un peering ad hoc
Points clés pour les responsables de la recherche européenne
- Le réseau est de plus en plus le facteur déterminant pour les performances réelles en physique et en sciences de la vie, en particulier avec des charges de travail mixtes IA + HPC.
- Cornelis CN5000 vise des performances prévisibles à grande échelle, où le comportement de congestion et la latence de queue dominent souvent le temps d'achèvement des travaux.
- Hammer aide à traduire cette capacité en une solution européenne fonctionnelle :
- Conçu
- Validé
- Déployé
Opérable en tant que service– pas seulement une collection de composants haute performance Contactez nos experts dès aujourd’hui pour discuter des solutions Cornelis Networks
Vous voulez en savoir plus ?