La fabrication intelligente en Europe a largement dépassé les API plus les tableaux de bord. Aujourd'hui, elle inclut l'inspection par vision par ordinateur, l'optimisation pilotée par l'IA, les jumeaux numériques qui nécessitent une fidélité en temps réel, et des clusters périphériques qui doivent se comporter comme de mini centres de données - de manière fiable, chaque jour.
Dans cette réalité, le problème de mise à l'échelle le plus courant n'est souvent pas le modèle ou le GPU. C'est le réseau : la congestion, la gigue et la perte de paquets apparaissent exactement lorsque vous ajoutez la ligne suivante, le prochain ensemble de caméras ou le prochain pipeline d'analyse.
C'est là qu'une capacité très spécifique devient centrale : Cornelis CN5000 Omni-Path® , positionné par Cornelis comme « le premier réseau scale-out sans perte et sans congestion au monde » - associé à Hammer Distribution pour rendre la conception, l'approvisionnement et le déploiement piloté par les partenaires réalisables dans toute l'Europe.[RM1]
Pourquoi l'IA d'usine sollicite les réseaux différemment
Les schémas de données industriels peuvent être un peu… brutaux. On voit souvent :
- Flux vidéo à haut débit alimentant simultanément les nœuds d'inférence et le stockage
- Moments “incast” en rafales lorsque de nombreux appareils signalent ensemble (alarmes, événements par lots, statistiques de fin de cycle)
- Trafic est-ouest entre les nœuds pour l'analyse, l'extraction de caractéristiques et la simulation
- Un mélange de flux quasi temps réel (contrôle d’inspection, coordination robotique) aux côtés d’un trafic moins critique
Dans les réseaux best-effort, les micro-rafales et la pression de file d'attente peuvent entraîner des pertes de paquets et des retransmissions - une voie courante vers les pics de latence de queue. (C'est pourquoi les conceptions “Ethernet sans perte” pour RDMA s'appuient généralement sur des mécanismes comme PFC et ECN/DCQCN, avec un réglage minutieux sur l'ensemble du chemin.)
La structure scale-out sans perte et sans congestion du CN5000
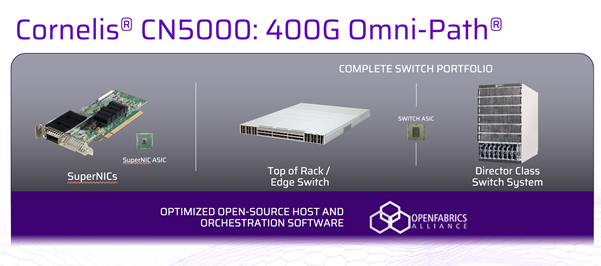
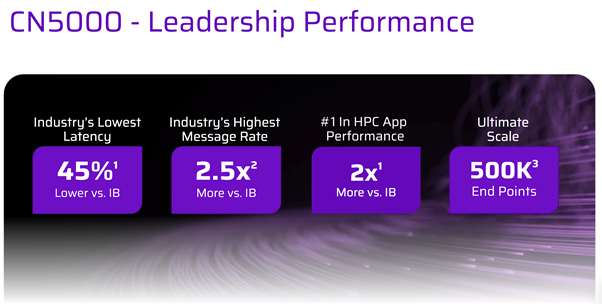
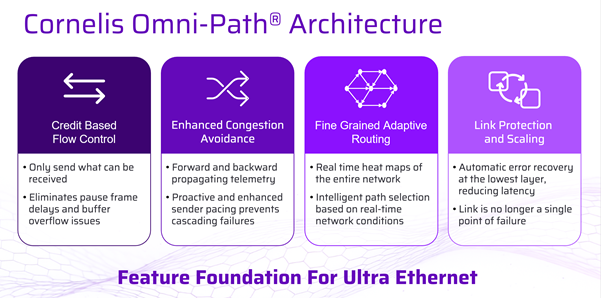
Cornelis décrit CN5000 comme offrant une transmission de données sans perte et sans congestion grâce à un contrôle de flux basé sur le crédit et un routage adaptatif dynamique à granularité fine, conçu pour maintenir un débit et une latence prévisibles lorsque les charges augmentent.
Une façon utile de le présenter aux fabricants :
Le CN5000 n’essaie pas de “gérer” la congestion après coup - il est conçu pour prévenir les pertes et gérer la congestion de manière comportementale à travers le réseau.
Les documents de Cornelis sur le commutateur de classe Director CN5000 mettent également en avant la télémétrie fine et l'analyse du trafic en temps réel pour détecter la congestion et optimiser les performances, ainsi que des points d'échelle à haute densité tels que jusqu'à 576 ports de 400G dans la plateforme de classe Director.
Comparaison : CN5000 Omni-Path vs approches réseau courantes pour les clusters IA/edge en usine
|
Ce qui vous importe dans la fabrication intelligente |
Cornelis CN5000 Omni-Path |
RoCEv2 sur Ethernet (conception Ethernet sans perte) |
InfiniBand (déploiements typiques) |
|
Objectif de conception principal |
Réseau scale-out sans perte et sans congestion pour les modèles de trafic de type IA/HPC |
RDMA sur Ethernet, généralement conçu pour se comporter sans perte pour les classes RDMA |
Comportement de fabric sans perte avec contrôle de flux basé sur le crédit (déploiements courants) |
|
Comment l'absence de perte est abordée |
Contrôle de flux basé sur le crédit + comportement de congestion au niveau du réseau (description Cornelis) |
Souvent via PFC + ECN/DCQCN (configuration et réglage de bout en bout requis) |
Contrôle de flux de liaison basé sur le crédit pour éviter les pertes dans le tissu (caractéristique typique) |
|
Gestion de la congestion |
Routage adaptatif + comportement de fabrica sensible à la congestion (description Cornelis) |
Signalisation de congestion et ajustement de débit de type ECN/DCQCN ; PFC comme filet de sécurité |
Mécanismes de fabric intégrés et outils opérationnels matures dans de nombreux environnements HPC |
|
Accent opérationnel |
Efficacité de mise à l'échelle + analytique de télémétrie/trafic (Cornelis) |
Fortement dépendant d'une configuration PFC/ECN cohérente sur l'ensemble du chemin |
Souvent choisi lorsque le comportement déterministe du réseau est priorisé |
|
Pourquoi c'est important en périphérie d'usine |
Aide à maintenir une latence prévisible lorsque la vision, l'analytique et la simulation se rencontrent dans le même pod |
Peut bien fonctionner, mais l'ingénierie de l'« Ethernet sans perte » fait partie du périmètre du projet |
Une option connue pour les infrastructures sans perte à faible latence (plus typique dans les environnements HPC) |
Le point n’est pas “il n’y a qu’une seule bonne réponse.” C’est que les clusters de fabrication intelligente en périphérie se comportent comme des environnements IA/HPC réduits, et le CN5000 est explicitement positionné pour ces modèles de trafic - sans perte, gérés en congestion, et observables à grande échelle.
Où Hammer s'intègre pour transformer une structure en solution européenne déployable
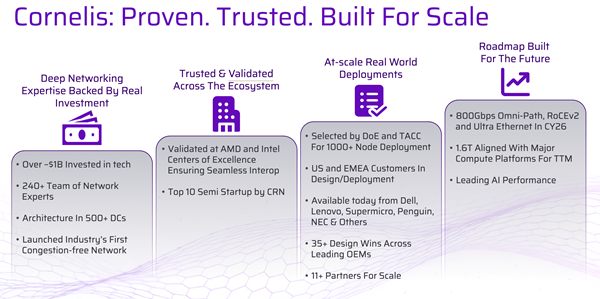
Les fabricants achètent rarement “un réseau” isolément. Ils achètent un résultat livré par un partenaire : une conception validée, des assemblages de racks intégrés, une logistique adaptée aux fenêtres de déploiement, et une maintenabilité qui ne s’effondrera pas lors du premier incident.
Donc, dans un contexte Cornelis, le rôle de Hammer est pragmatique : aider le canal à livrer le CN5000 d'une manière qui correspond à la façon dont la fabrication européenne a tendance à déployer les projets - pod pilote → première ligne → premier site → répétabilité multi-sites.
Cas d'utilisation qui correspondent parfaitement à l'ensemble de fonctionnalités du CN5000
1) Pods d'inspection visuelle qui ne tolèrent pas les fluctuations de performance
L'inspection haute résolution crée un débit soutenu ainsi que des rafales (métadonnées, écritures de stockage, déclencheurs d'événements). Un comportement sans perte et géré par congestion contribue à réduire l'effet “c'était bien jusqu'à ce que nous ajoutions deux caméras supplémentaires”.
2) Boucles de jumeau numérique nécessitant une fidélité en temps réel
Un jumeau alimenté en retard devient un outil de reporting, et non un outil opérationnel. Le positionnement du CN5000 autour de la transmission sans congestion plus la télémétrie/analytique est directement pertinent lorsque vous avez besoin de flux stables et observables à la périphérie.
3) Analytique d'usine à grande échelle - sans la phase réseau fragile
À mesure que vous passez d'une ligne à plusieurs, la pression de rafale et le comportement de type incast deviennent plus courants. Si la perte de paquets commence à entraîner des retransmissions et une latence de queue, la stabilité en souffre. Un réseau conçu pour rester sans perte sous charge change la donne en matière de mise à l'échelle.
Architecture de référence : un “pod IA d'usine” qui évolue
Un modèle simple et reproductible qui fonctionne bien est le pod d'IA d'usine : un cluster périphérique autonome qui exécute les traitements en temps réel localement, tout en s'intégrant en amont pour l'entraînement et l'optimisation à l'échelle de la flotte.
Composants principaux
- 4–32 nœuds GPU/CPU pour l'inférence + l'analytique
- Stockage local haute performance (tampons de vision, fonctionnalités, rétention courte)
- Un tissu d'extension dédié pour le trafic est-ouest (là où se situent la plupart des problèmes)
- Connectivité sécurisée nord-sud vers le réseau de l’usine et les services centraux
Où se situe le CN5000 :
- En tant que tissu est-ouest entre le calcul et le stockage pour maintenir une latence prévisible sous charge mixte
- Fourniture de télémétrie et d'analytique du trafic pour repérer la congestion et optimiser les performances avant que les opérateurs ne remarquent une dérive
Où Hammer aide :
- Conceptions validées menées par les partenaires et intégration en rack afin que chaque déploiement de pod soit reproductible sur tous les sites
Le grand avantage : cette architecture évolue sur le plan opérationnel. Une fois que vous pouvez déployer proprement le Pod v1, vous pouvez le répliquer dans les usines avec beaucoup moins d'inconnues.
Opérationnaliser la performance avec la télémétrie (car les usines n'ont pas le temps pour les conjectures)
Les problèmes de réseau dans la fabrication arrivent rarement poliment. Ils arrivent comme :
- manques d'inspection intermittents
- délais d'inférence inexpliqués
- une ligne qui “semble plus lente” après une mise à jour
- des travaux d'analyse nocturnes qui dépassent soudainement la fenêtre de maintenance
C’est pourquoi l’accent mis par CN5000 sur la télémétrie fine et l’analyse du trafic en temps réel est plus qu’une simple fonctionnalité - c’est un facilitateur opérationnel. Cornelis décrit explicitement la télémétrie/analyse utilisée pour détecter la congestion et optimiser les performances sur un grand nombre de points de terminaison.
En termes pratiques, la télémétrie prend en charge :
- Isolation plus rapide de la cause racine (calcul, stockage ou réseau ?)
- Réglage proactif (repérer les liens et modèles chauds à l'avance)
- Mise à l'échelle plus sûre (ajouter des caméras/nœuds avec des preuves, pas de l'espoir)
Et parce que Hammer prend en charge la livraison et l’intégration par les partenaires, vous pouvez intégrer ces attentes opérationnelles dans le déploiement dès le premier jour plutôt que d’ajouter l’observabilité après coup, après la première alerte de production.
Conclusion : traiter le réseau comme une architecture de première classe
Si vous tenez vraiment à accélérer la fabrication intelligente en Europe, traitez le réseau comme un élément de première classe de l’architecture.
Cornelis CN5000 apporte une structure conçue et commercialisée pour des performances d'extension sans perte et sans congestion, avec un routage adaptatif et une visibilité approfondie.
Hammer contribue à rendre cette capacité déployable via le canal européen - répétable, supportable et conçu pour la croissance.
FAQ : Cornelis CN5000 dans la fabrication intelligente
À quoi sert le Cornelis CN5000 dans la fabrication intelligente ?
Le CN5000 est utilisé comme interconnexion est-ouest à l’intérieur d’un “AI pod” d’usine ; le tissu haute vitesse entre les nœuds de calcul (GPU/CPU), le stockage local et les services d’analyse. Dans la fabrication intelligente, ce trafic interne est l’endroit où les flux vidéo, l’extraction de caractéristiques et la simulation/analyse se rencontrent, et où la congestion apparaît en premier lorsque vous faites évoluer les caméras, les lignes et les pipelines. L’objectif est une latence et un débit prévisibles sous charge, et non pas seulement une bande passante de pointe élevée.
Pourquoi les charges de travail d'IA en usine provoquent-elles une congestion du réseau et de la gigue ?
Les données d'usine ont tendance à être à haut débit, en rafales et synchronisées :
- Plusieurs flux vidéo peuvent atteindre l'inférence et le stockage en même temps.
- “Incast” se produit lorsque de nombreux appareils signalent en même temps (alarmes, événements de fin de cycle, achèvements de lots).
- Vous obtenez un débit soutenu plus des micro-rafales, ce qui augmente la pression sur les files d’attente.
Sur les réseaux à effort maximal, cela se transforme souvent en accumulation de files d'attente, en pertes de paquets et en retransmissions, ce qui est exactement la façon dont les pics de latence de queue apparaissent, généralement juste au moment où vous ajoutez “une caméra, une ligne ou un pipeline de plus”.
En quoi le CN5000 diffère-t-il des conceptions “Ethernet sans perte” comme RoCEv2 ?
Dans de nombreux environnements RoCEv2, le comportement “Ethernet sans perte” est obtenu en concevant le chemin Ethernet (généralement avec PFC + ECN/DCQCN) et en le réglant de bout en bout.
Le CN5000 est généralement positionné comme adoptant une approche différente : contrôle de flux basé sur le crédit et gestion de la congestion au niveau du réseau (plus routage adaptatif) pour éviter que les pertes et la congestion ne s'aggravent.
La différence pratique réside dans l'endroit où se trouve la complexité opérationnelle :
- RoCEv2 : plus dans la discipline de configuration/réglage Ethernet
- CN5000 : plus dans la conception du réseau + la politique, avec moins de dépendance aux réglages “Ethernet sans perte”
Quand un fabricant choisirait-il CN5000 Omni-Path plutôt qu'InfiniBand ?
Les deux visent un comportement prévisible et à faible gigue pour le calcul extensible. La décision se résume généralement à l'écosystème et aux opérations :
- Choisissez l'option qui correspond le mieux à votre chaîne d'outils existante, à vos compétences, à votre modèle de support et à votre réalité d'approvisionnement.
- Use a “pod” lens: if your edge cluster behaves like a mini AI/HPC environment and you care most about stable scaling under mixed workloads, compare them on real collective-heavy and bursty factory patterns, not just clean lab benchmarks.
Comment la télémétrie et l'analytique du trafic aident-elles les opérations en périphérie d'usine ?
Les problèmes de réseau d'usine se présentent rarement comme des alarmes bien nettes. Ils se manifestent comme :
- manques d'inspection intermittents
- délais d'inférence inexpliqués
- travaux d'analyse qui dépassent les fenêtres de maintenance
La télémétrie à granularité fine vous aide à répondre rapidement à la question “calcul, stockage ou fabric ?”, et à repérer les liens chauds, les schémas de congestion ou les effets de voisin bruyant avant que les opérateurs ne ressentent la dérive des performances. C'est ce qui rend la mise à l'échelle plus sûre ; vous ajoutez des caméras/nœuds avec des preuves, pas des suppositions.
Quel rôle Hammer Distribution joue-t-il dans le déploiement de CN5000 en Europe ?
Le rôle de Hammer est généralement de rendre la structure déployable et reproductible plutôt que « simplement achetée » :
- conceptions validées mappées à la charge de travail
- constructions de racks intégrées et pré-tests
- logistique alignée sur les fenêtres de déploiement
- modèles de support pour les incidents réels (opérations de jour 2)
En pratique, cela soutient le parcours courant des fabricants : pod pilote → première ligne → premier site → répétabilité multi-sites.
Qu'est-ce qu'un « pod IA d'usine » et où le réseau s'intègre-t-il ?
Un pod IA d'usine est un cluster périphérique reproductible qui exécute l'inférence et l'analytique en temps réel localement, tout en s'intégrant en amont pour l'entraînement et l'optimisation de la flotte. Un modèle typique comprend :
- ~4–32 nœuds GPU/CPU
- stockage local haute performance
- un tissu dédié est-ouest
La plupart des problèmes de mise à l'échelle se situent dans cette couche est–ouest, c'est donc le tissu que vous choisissez pour maintenir une latence stable sous des charges mixtes et en rafales.
Quels cas d'utilisation de la fabrication intelligente bénéficient le plus d'une infrastructure sans perte et gérée contre la congestion ?
Cas d'utilisation qui combinent un débit soutenu avec des rafales et une synchronisation :
- Pods d'inspection visuelle (flux + rafales de métadonnées + écritures de stockage)
- Boucles de jumeau numérique où le retard transforme “les opérations” en “rapports”
- Analyses à grande échelle sur plusieurs lignes (modèles fréquents d'incast et de mélange)
Le thème commun : éviter la latence de queue induite par les retransmissions qui déstabilise les performances en temps réel.
Quels sont les signes courants indiquant que le réseau est le goulot d'étranglement dans l'IA en périphérie ?
Symptômes qui semblent “mystérieux” en production :
- Omissions d'inspection intermittentes ou taux de rejet incohérents
- Timing d'inférence inégal (même modèle, moments de latence différents)
- La ligne « semble plus lente » après mise à l'échelle ou mises à jour
- Les travaux de nuit/fenêtre de maintenance dépassent soudainement la fenêtre
Si le système était stable puis se dégrade après l'ajout de la caméra/ligne/pipeline suivante, le réseau est un suspect fréquent, surtout lorsque le problème n'apparaît qu'en cas de concurrence maximale.
Vous voulez en savoir plus ?